臉和聲音都對得上才放行,只需要一般的網路攝影機和麥克風。
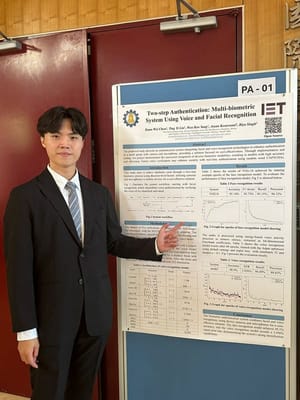
雙階段驗證設計:先以 VGG16 人臉分類器辨識已註冊使用者,再以 ResCNN 語者編碼器驗證其聲音,僅需一般網路攝影機與麥克風;發表於 ICETA 2024。
研究方向
人臉與語音身分驗證、自動點名與考試監考。
從門禁到考場,各種場合都需要確認身分,但密碼容易外流,單一生物特徵也可能被偽造。我們希望打造足夠安全、可信賴,又輕量到能在低價硬體上執行的系統。
我們的系統結合人臉辨識與語音驗證,並採用輕量網路以便部署於邊緣裝置。在雙階段驗證設計中,先由 VGG16 人臉分類器辨識使用者,再由 ResCNN 語者編碼器驗證聲音,兩個階段都通過才算驗證成功。監考系統則結合 Swin Transformer 語意分割與 ShuffleNet V2 人臉辨識,以偵測作弊行為。
代表性專案皆公開於 GitHub:雙階段多生物特徵身分驗證(ICETA 2024)、人臉辨識點名管理系統,以及輕量語意分析監考系統。
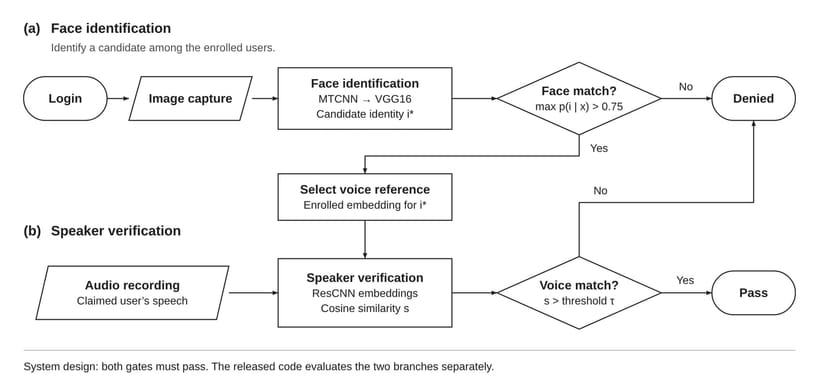
人臉比對通過後,系統選出該使用者已註冊的聲音參考,語者驗證也必須通過;任一關未過就拒絕進入。程式碼釋出中,人臉辨識在五位註冊學生上的準確率約 95%,語者驗證在 LibriSpeech 上約 99%,兩者分別測試。圖取自程式碼釋出。
前往 GitHub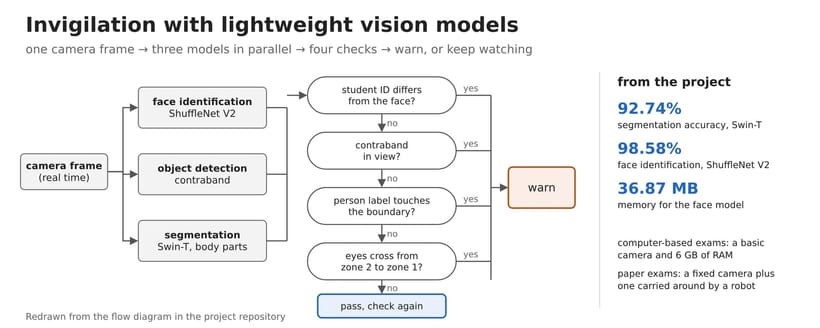
三個模型同時分析每一張攝影畫面:考生是誰、畫面中有沒有手機或耳機,以及每個人的身體位置。接著由四項檢查決定是否提醒監考人員。模型小到能在邊緣裝置上執行。依 repo 中的流程圖重繪。
前往 GitHub臉和聲音都對得上才放行,只需要一般的網路攝影機和麥克風。
雙階段驗證設計:先以 VGG16 人臉分類器辨識已註冊使用者,再以 ResCNN 語者編碼器驗證其聲音,僅需一般網路攝影機與麥克風;發表於 ICETA 2024。
用攝影機協助監考:辨識考生身分並理解場景,運算量小到能在教室現場的裝置上執行。
以視覺為基礎的監考系統,結合 Swin-T 語意分割(準確率 92.74%)與 ShuffleNet V2 人臉辨識(98.58%),於決策層融合,可部署於邊緣裝置。
成員 林庭毅
用攝影機認臉,自動點名。
以 Tkinter 與 OpenCV 開發的桌面應用程式,可擷取人臉影像、訓練辨識模型並即時記錄出席,結果存入 CSV 或 MySQL 資料庫,亦可手動補登;由 TEEP 計畫支持。
2025 IEEE International Conference on Consumer Electronics - Taiwan (ICCE-Taiwan), pp. 349–350
以 MFCC、音高曲線、頻譜圖與小波分析比較台灣中英雙語者與印度英語使用者的語音:台灣語音的音高變化與聲調轉折較大,印度語音的節奏較穩定。結果可作為針對不同語者選擇語音辨識與語者驗證模型的依據。
Two-step Authentication: Multi-biometric System Using Voice and Facial Recognition
IET International Conference on Engineering Technologies and Applications (ICETA 2024), IET Conference Proceedings, vol. 2024, no. 22, pp. 11–12
結合人臉與聲音辨識,為小團體打造只需攝影機與麥克風的低成本身分驗證:人臉模型先辨識使用者,語者模型再驗證聲音。程式碼與模型皆公開。