同時聽語氣和內容判斷情緒,給出各種情緒的可能性,而不是只貼一個標籤。
比較雙向 Mamba 與 Transformer 骨幹於 IEMOCAP 文字加語音多模態情緒辨識的表現,並採用聯合 Valence-Arousal 機率輸出;為 arXiv 預印本 2609.05755 的程式碼釋出。
研究方向
以 AI 分析生理訊號與語音:肌肉異常檢測與多模態情緒辨識。
生理訊號與語音蘊含了人的身體與情緒狀態,但這些資料雜訊多、個體差異大,且常須在小型裝置上分析。我們的目標是建立準確、高效並兼顧隱私的模型。
我們的研究涵蓋以生理訊號進行肌肉異常檢測,以及結合語音與文字的多模態情緒辨識。在情緒辨識方面,我們比較 Mamba 狀態空間模型與 Transformer 在文字與語音上的表現,並預測聯合的 Valence-Arousal 機率分布,而非單一標籤。較早期的工作則結合小波轉換與類神經網路,在低成本微控制器上分析心電圖心跳訊號。
代表性成果包括 EchoMind Mamba-VA-SER 程式碼釋出(對應預印本 “Emotion as a Distribution”,arXiv:2609.05755),以及嵌入式小波類神經網路心電圖分析專案,皆可於專案頁面查閱:EchoMind-Mamba-VA-SER、ECG 小波類神經網路。
歷屆碩士論文也把同樣的工具用在醫療照護上:以小波類神經網路辨識嬰兒哭聲型態、醫療物聯網應用於產科病房新生兒室內定位、以 YOLOv5 遷移式學習辨識人臉情緒,以及肌電訊號肌肉疲勞偵測的傳統與深度學習對照研究。
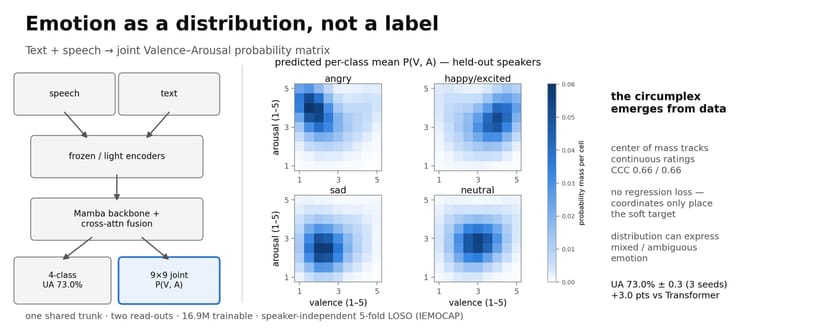
文字與語音輸入雙向 Mamba 模型,同時給出四類情緒判斷與 9×9 的 Valence-Arousal 機率分布。圖取自程式碼釋出。
前往 GitHub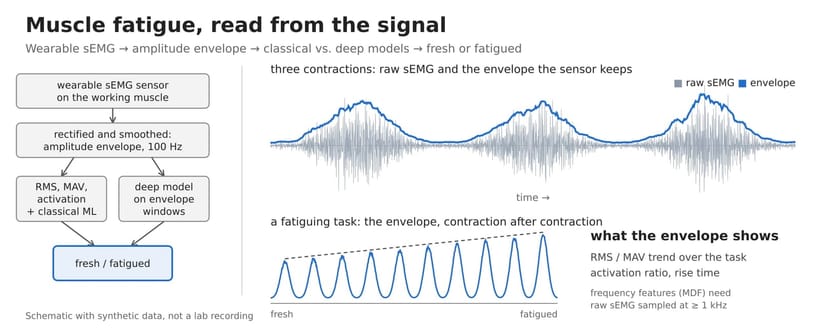
穿戴式感測器記錄肌肉訊號的振幅包絡,疲勞會反映在任務中振幅的變化。我們比較傳統特徵方法與深度學習模型的偵測效果。此圖為示意圖,以合成資料繪製。
了解更多同時聽語氣和內容判斷情緒,給出各種情緒的可能性,而不是只貼一個標籤。
比較雙向 Mamba 與 Transformer 骨幹於 IEMOCAP 文字加語音多模態情緒辨識的表現,並採用聯合 Valence-Arousal 機率輸出;為 arXiv 預印本 2609.05755 的程式碼釋出。
在平價微控制器上判讀心電圖,分辨不同類型的心跳。
以小波轉換進行心電圖心跳訊號的前處理與特徵擷取,並以 ANN 與 CNN 分類心跳,部署於低成本微控制器(Arduino Nano、ESP8266 MicroPython)。
arXiv:2609.05755 (submitted to Speech Communication), 2026
把說話者的情緒看成分布:模型除了四類情緒判斷,也輸出 Valence-Arousal 平面上 9×9 的機率圖。在 IEMOCAP 文字與語音資料上以跨說話者方式評估,雙輸出模型的未加權準確率達 73.0%,比 Transformer 融合基準高 3 個百分點,改用凍結的 WavLM 特徵可達 76.6%。